本篇目录
说明
收集了各种公开非公开的资料,恶补一下。
数据模型
Bill Inmon 提倡范式建模(ER 建模),站在企业角度自上而下进行数据模型构建。Ralph Kimball 提倡的维度建模方法,从业务需求出发自下而上构建数据模型。
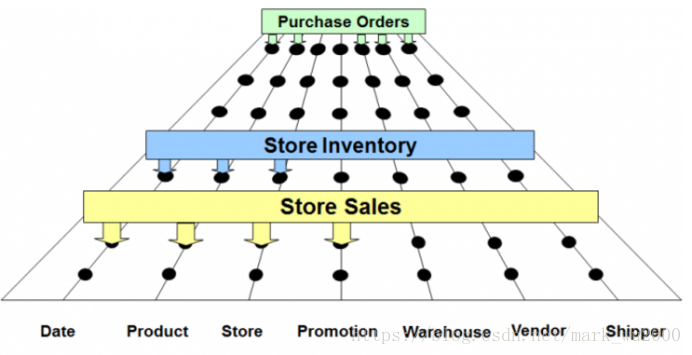
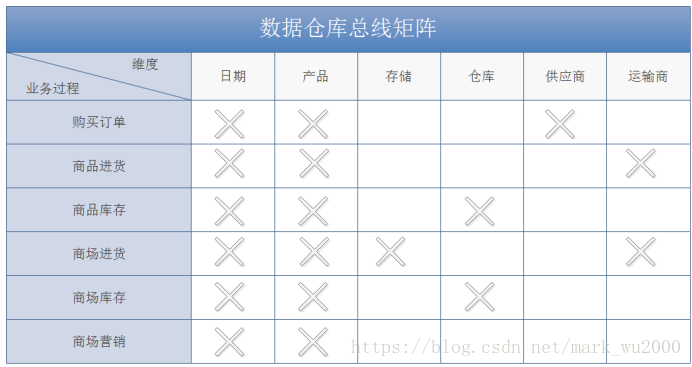
数据总线矩阵
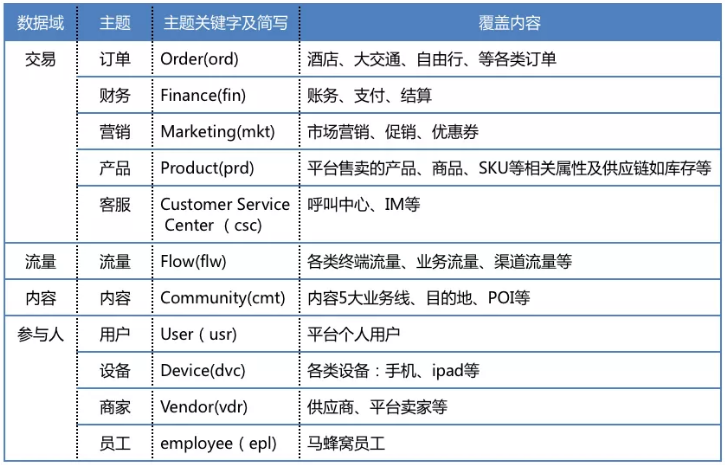
马蜂窝的实践
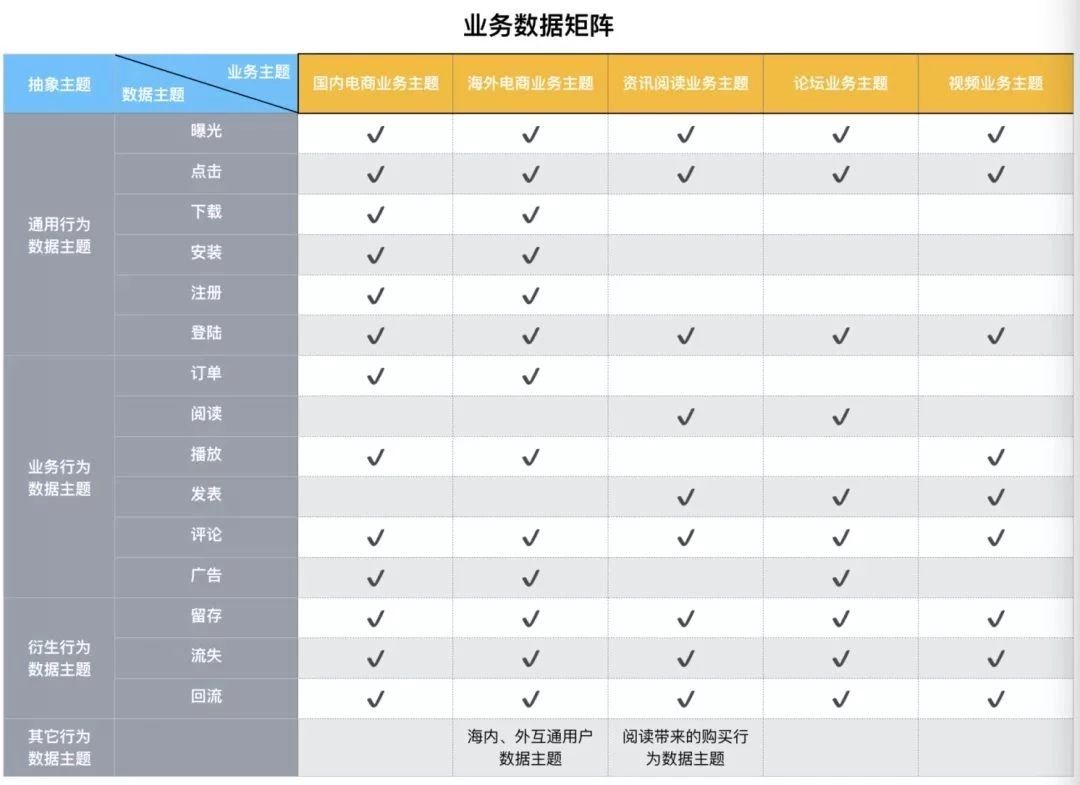
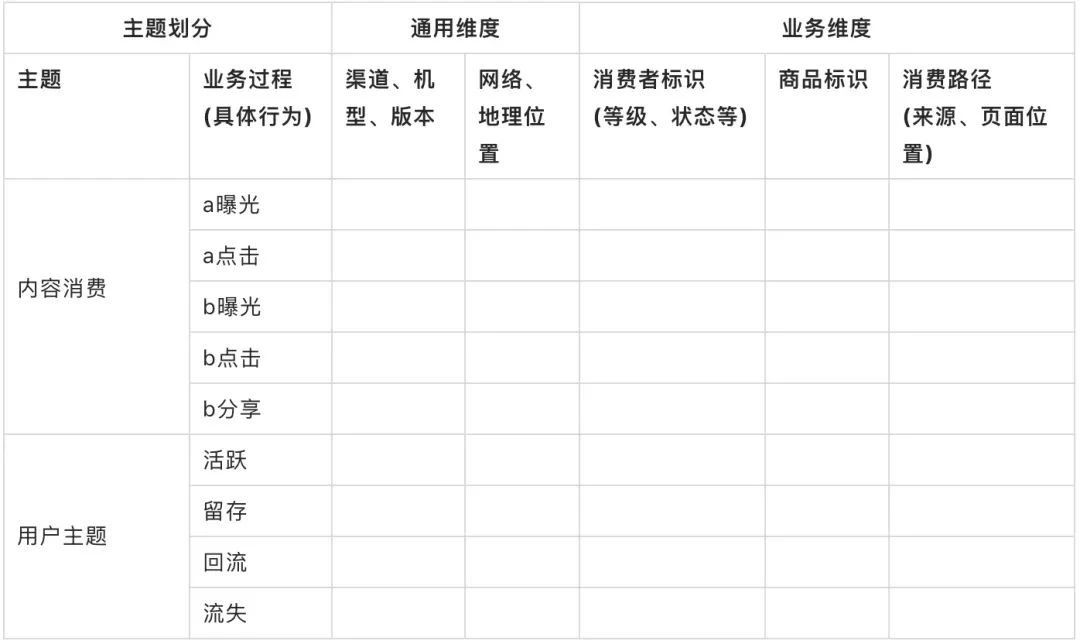
- 采用范式模型理论中的主题划分方法分类
- 建立统一的维度表和事实表
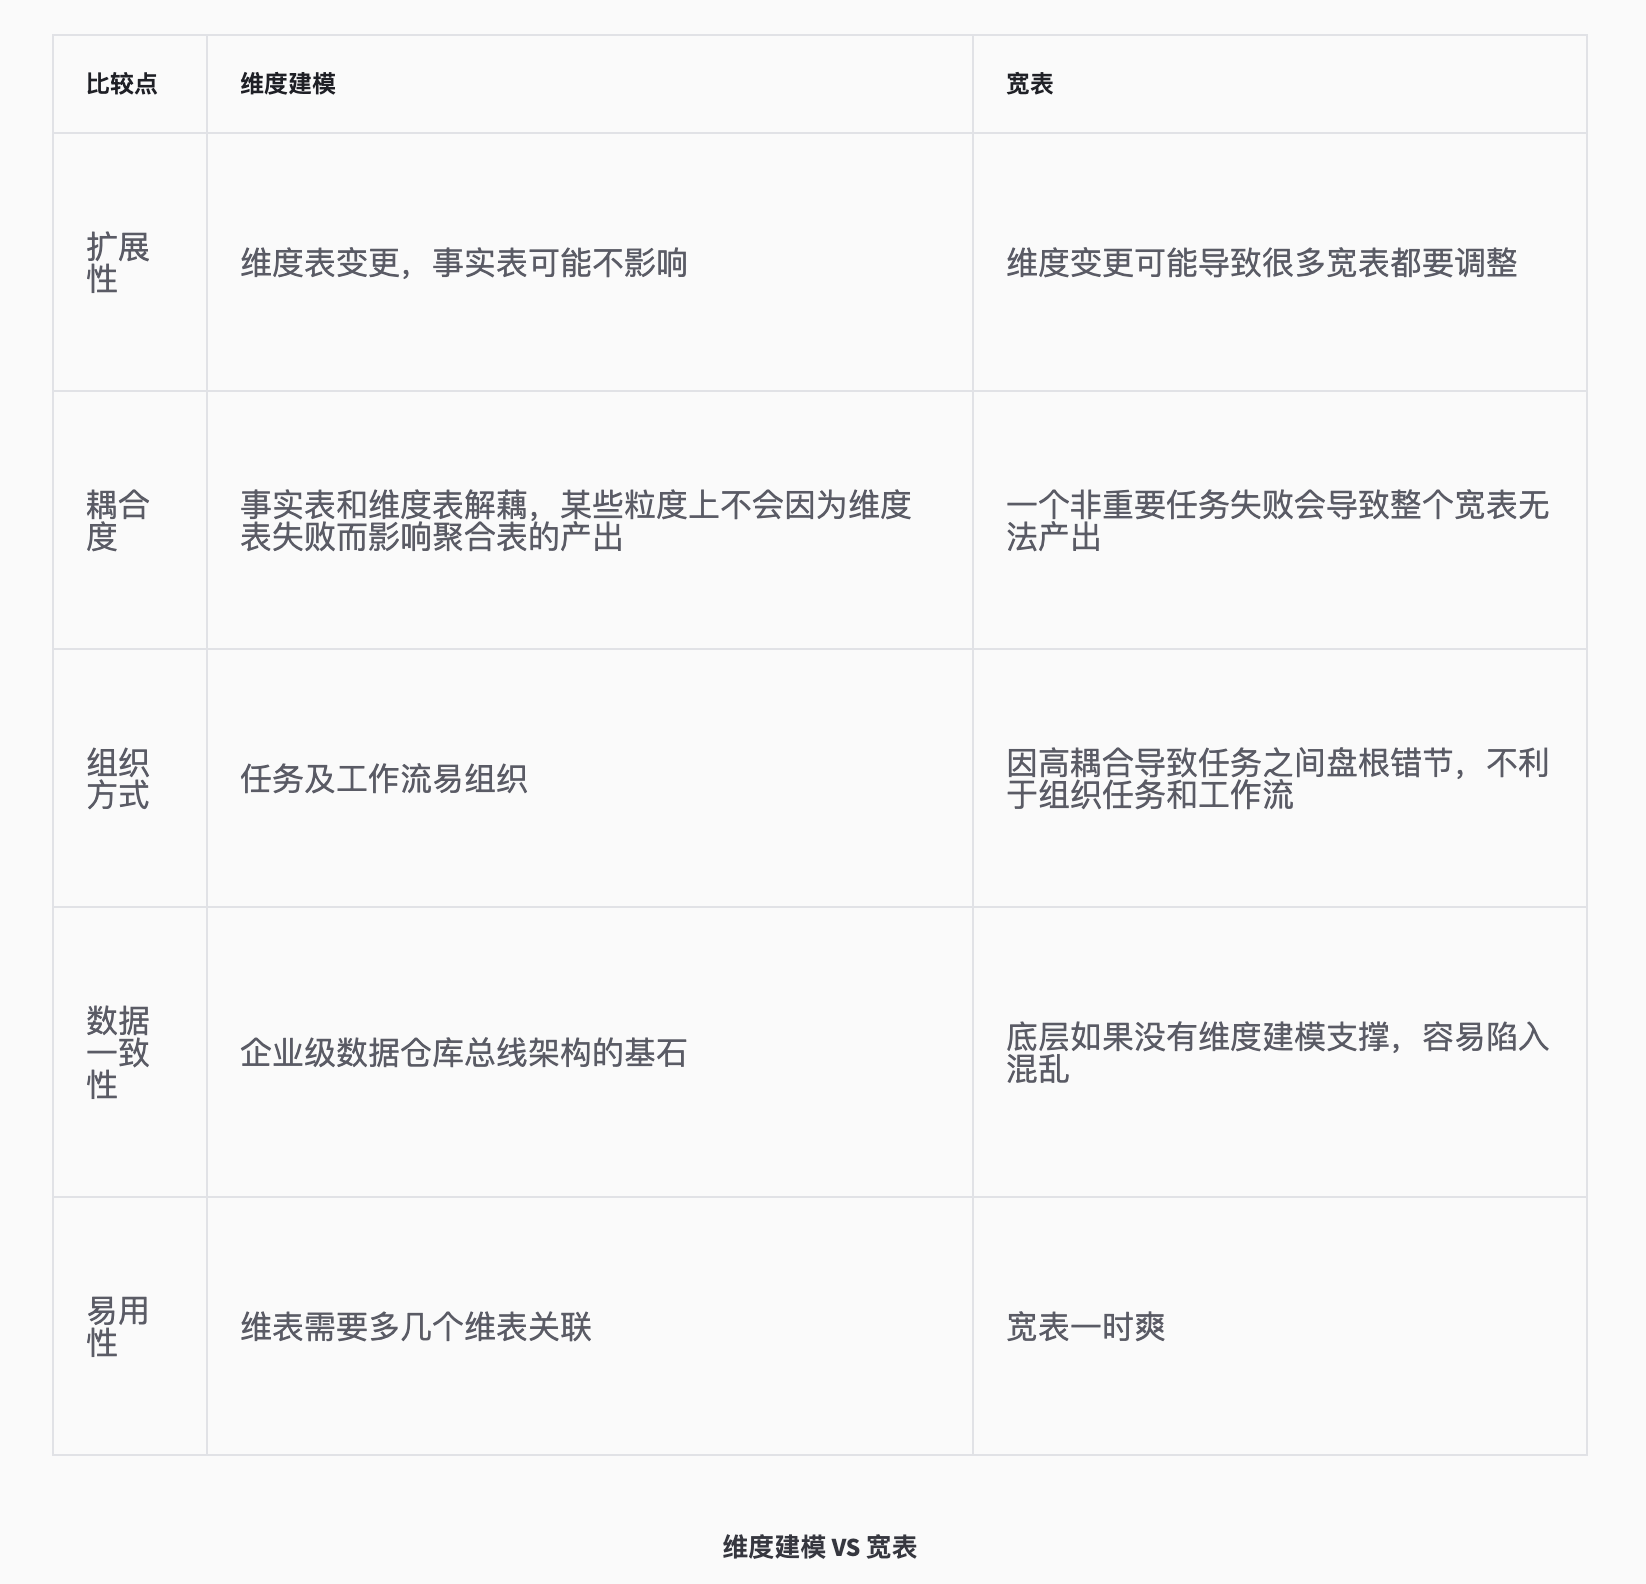
- 宽表是基于维度模型的扩展
- 水平整合:将同一业务多数据源的数据整合到一个模型中
- 垂直整合:将同一业务中各关键点信息整合到
业务全流程宽表
采用基于业务生产总线的设计方法,提炼各个节点发生的事实信息:
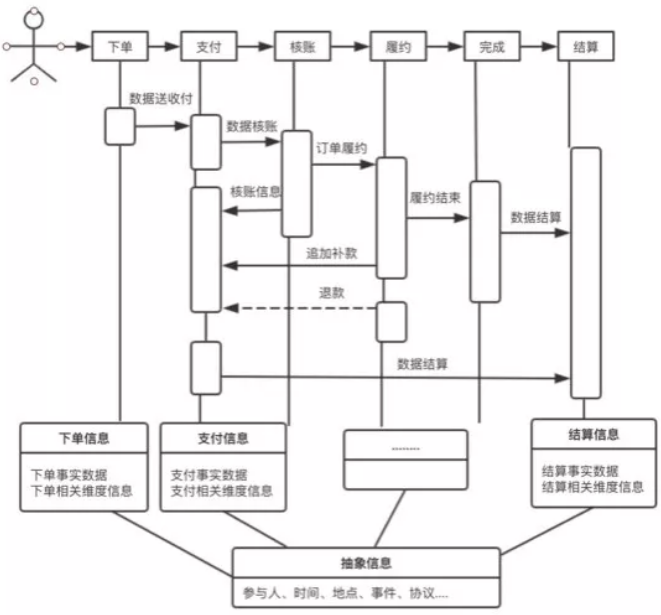
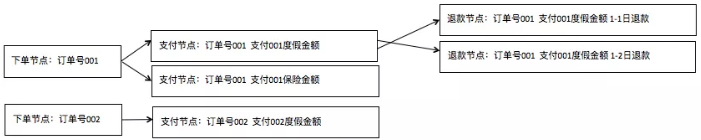
总线架构可以在模型中不断添加各个节点的核心信息,随着业务流程的推进,数据会出现拆分、汇聚。
数据拆分问题的解决方法:
下单节点数据是订单粒度,在支付节点可能发生数据拆分(譬如分两次支付,产生两个支付事实)解决方法是输出不同粒度的模型,既存在订单粒度的模型,也存在支付粒度的模型。
整合旅游、交通、酒店等各业务线与各业务节点信息的马蜂窝全流程订单模型:
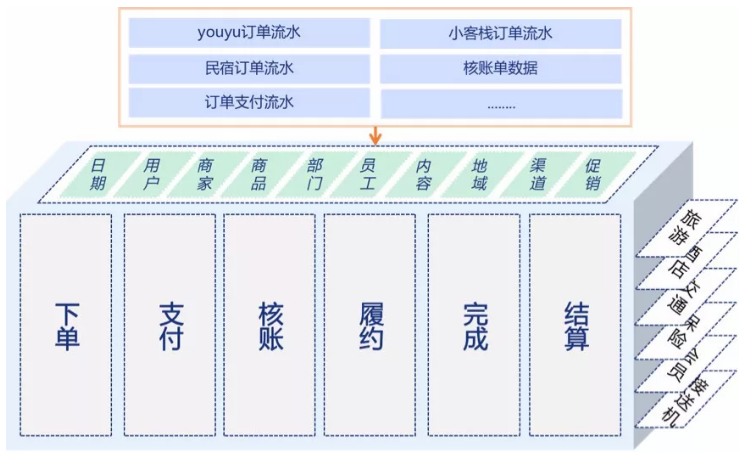
业务流程:下单、支付、核账、履约、完成、结算。
维度:绿色的是通用的维度。
事实:最上方的各种流水是引用了维度的事实。
应用:最右侧是该模型在不同业务领域的应用。
整合各节点信息后,根据实际需要进一步扩展常用的分析维度,通过冗余维度信息,减少关联分析维度的资源消耗。
有赞的实践
有赞数据仓库实践之路,主题域的划分经验:
- 主题域的划分强依赖于对业务层面的理解
- 有赞的主题域也随着有赞业务的发展,从最初的大约十个到如今的三四十个
- 曾经的维度建模经验加上如今的宽表经验,使我相信维度建模依然是目前数据仓库最佳的选择
在 Kimball 早期的理论中还会单独提及并解释落地层 (Staging Area) 的作用,在后期就只提到展现层,而将落地层弱化成为整个 ETL 的一部分。
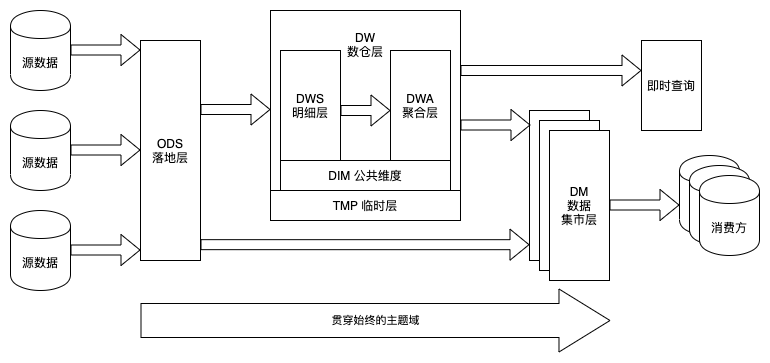
1. 数仓层内的划分更应该符合使用者的思维习惯。 DW 内的分层没有最正确的,只有最适合你的
2. 承载一致性维度 (conformed dimension) 的维度层是独立于事实并贯穿于数仓层全局的
3. 提供了两种类型的事实表:明细表和聚合表,在我们的数仓层里,还会有明细层和聚合层
4. 明细层保留的关键字是 DWS (Data Warehouse Service),聚合层保留的关键字是 DWA (Date Warehouse Aggregation)
没有按照 Kimball 的理论,显性地将事实表按照事务 (Transaction)、周期快照 (Periodic Snapshot) 和累积快照 (Accumulating Snapshot) 三种类型来划分。尽管这三种类型普遍存在于我们的数据仓库内,但由于用户并不容易理解三种事实表类型的划分方式,因此按照明细表和聚合表的方式分层,更容易让用户找到需要的表。
分层架构
数仓系统的架构,通常采用分层的设计。
有赞最新架构
大数据环境下的数据仓库是指对全局数据(包含时间和空间:历史的以及所有业务部门的)的存储及使用的一整套方法论。
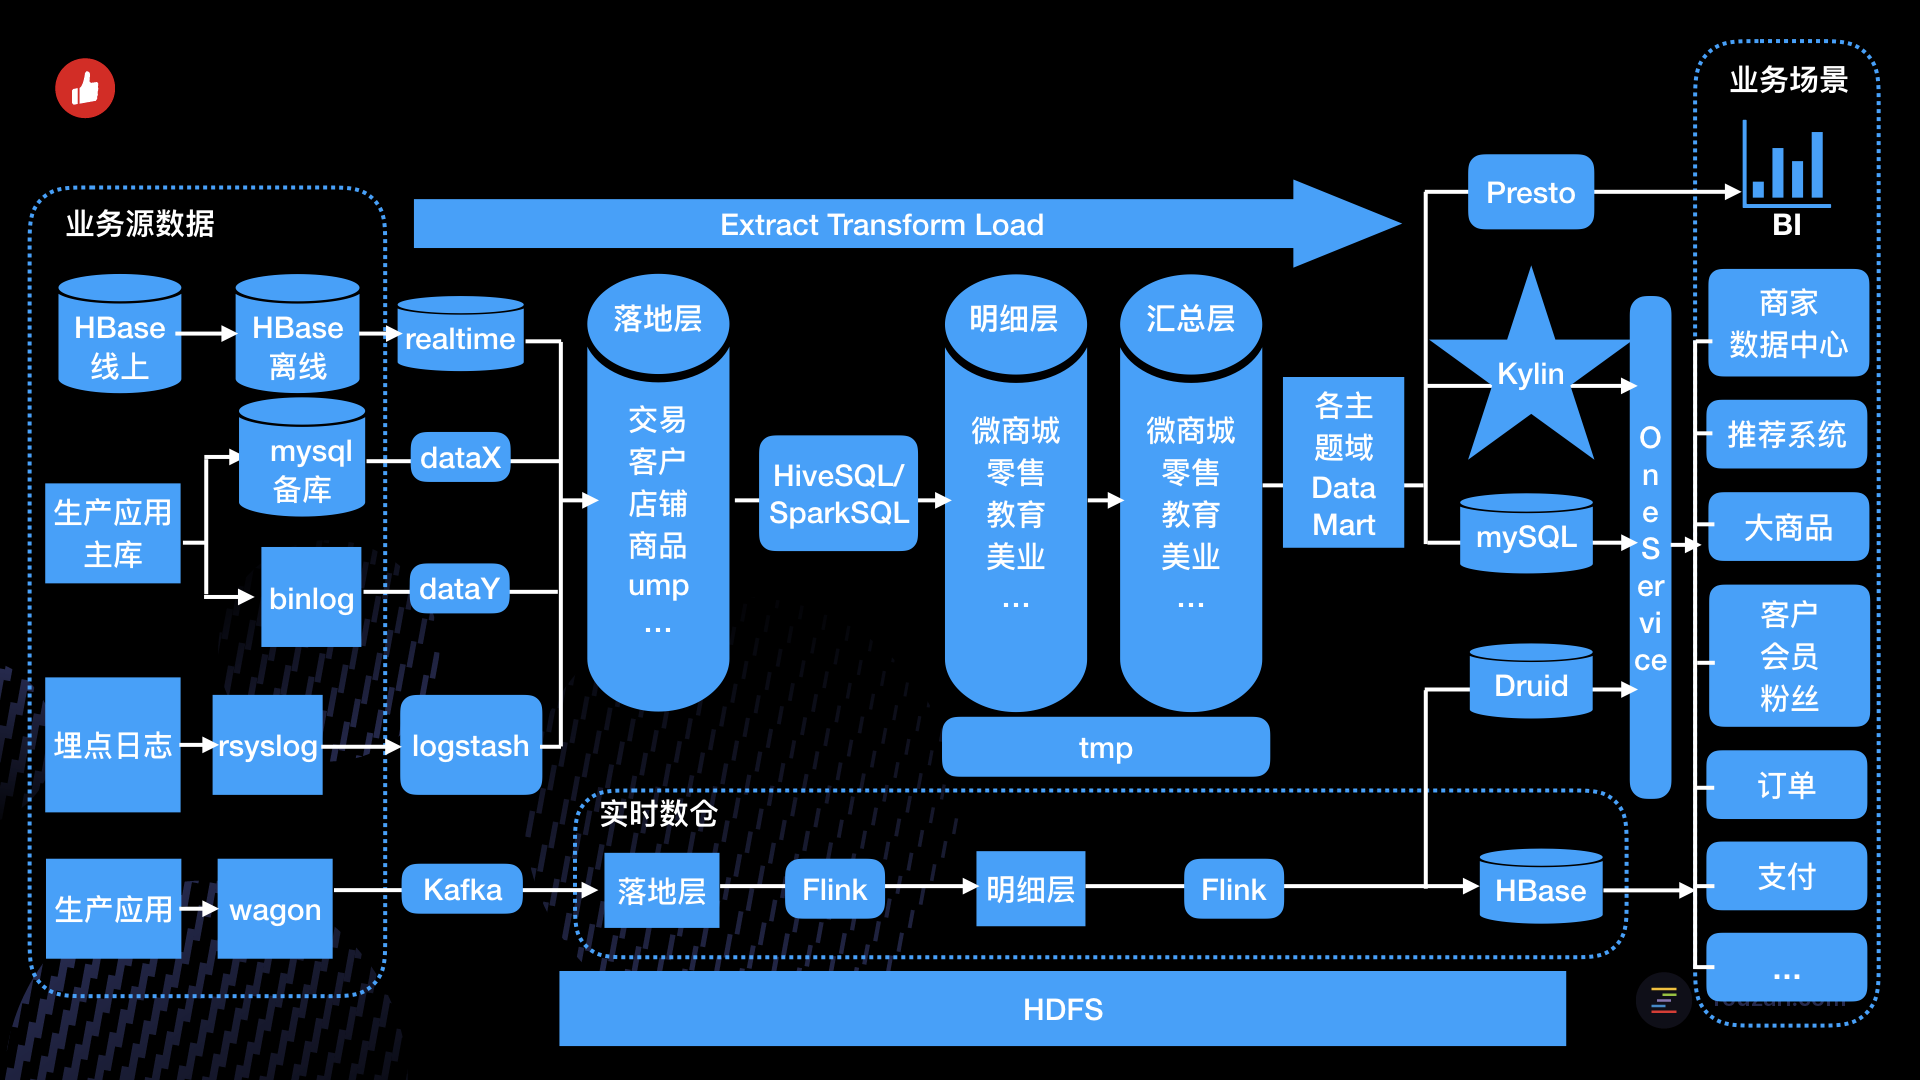
分为 3 层:ODS 落地层、DW 数据仓库层、DM 数据集市层。
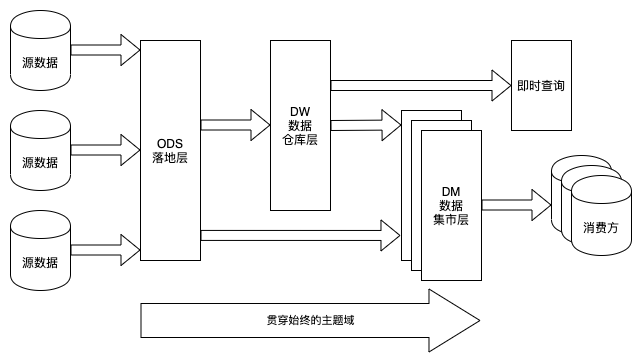
ODS 层建设经验:
- 给每个表添加主题域前缀,主题域下表名重复,添加后缀
- 中间层建设赶不上需求时,让业务方直接使用落地层
DW 数仓层建设经验:
- 根据当时业界较为通行的做法将整个数仓层又划分成了 dwd、dwb 和 dws 三层。然而我们却始终说不清楚这三层之间清晰的界限是什么,或者说我们能说清楚它们之间的界限,复杂的业务场景却令我们无法真正落地执行。
- 由于缺乏维度层,我们的维表显得无处安放;由于缺乏临时层,我们的中间结果和对外发布的表混在了一起。
- 三级分层只完成了我们的数据流向规范——从 dwd 到 dwb 再到 dws,层级之间不可逆向依赖。
- 宽表迄今为止并没有一个明确的定义,通常做法是把很多的维度关联到事实表中,形成一张既包含了大量维度又包含了相关事实的表。
- 宽表的使用有其一定的便利性。使用方不需要再去考虑跟维度表的关联,也不需要了解维度表和事实表是什么东西。
- 随着业务的增长,我们始终无法预见性地设计和定义宽表究竟该冗余多少维度,也无法清晰地定义出宽表冗余维度的底线在哪里。
- 一个可能存在的情况是,为了满足使用上的需求,要不断地将维表中已经存在的列增加到宽表中,这直接导致了宽表的表结构频繁发生变动。
DM 数据集市层:
- 各个数据集市之间不允许做数据依赖。
- 如果要配合 Kylin 使用的话,依然建议保持星型模型——它能最大限度的发挥 Kylin 预聚合的优势。
提供了两种类型的事实表:明细表和聚合表,在我们的数仓层里,还会有明细层和聚合层。在我们生产明细表和聚合表的时候,不可避免地会产生许多中间结果。所有这些中间结果并不承担对外提供服务的职责——它们对数据仓库的使用者是不可见的。我们为此单独设计了一个临时层来存放数仓层加工过程中可能产生的各种结果。
命名规范:
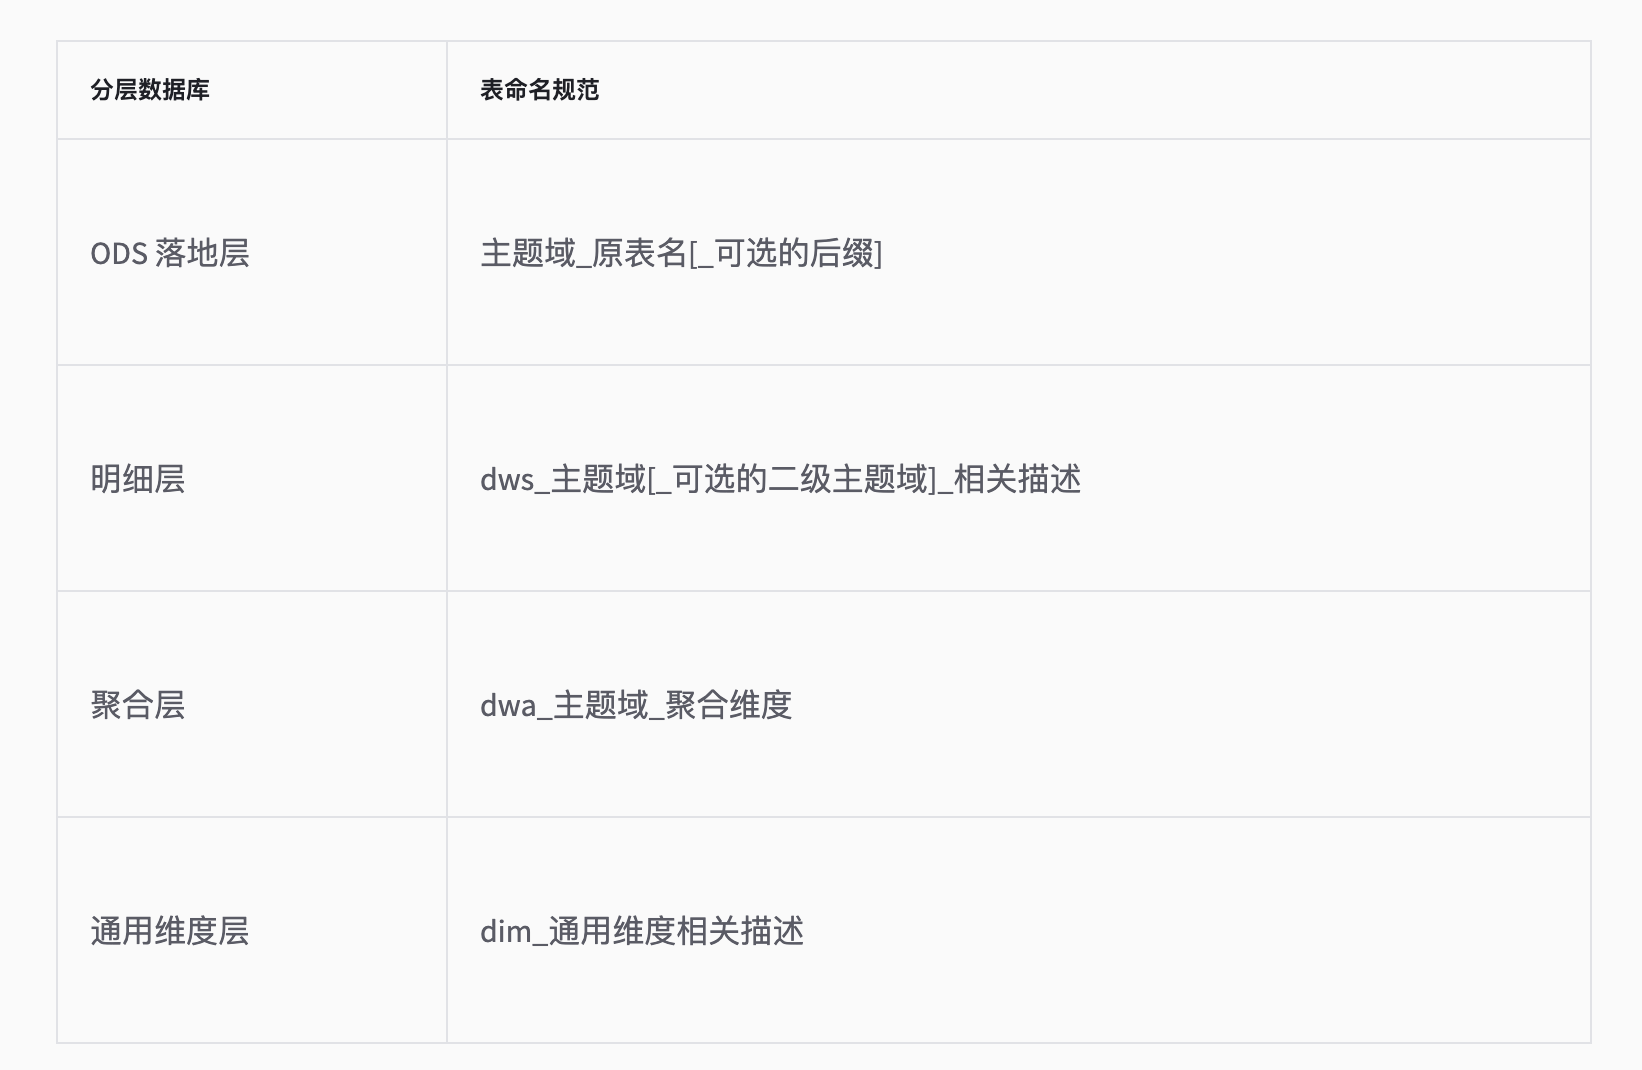
- 在有赞,聚合表的时间后缀只表示该表的聚合粒度,与 ETL 的调度周期或处理方式无关
- 同名同义性是我们对字段命名的首要要求。如果两个字段名字一样,那么它们的含义应该是一样的;反之,如果两个字段名字不一样,那么它们的含义就一定是要有区别的。当这个要求放在单个主题域内的时候,还是容易实现的。当它推广到全域范围内,这个事情就会变得有些困难。
- 其次,字段名称清晰是另外一个要求。良好的字段命名应当是自解释的,如果看完字段的注释还无法理解甚至曲解字段的含义,那个可以说这个字段的命名和注释是不合格的。
- 一个任务只写一张目标表,同时任务的命名中必须包含该目标表的表名。
有赞早期分享
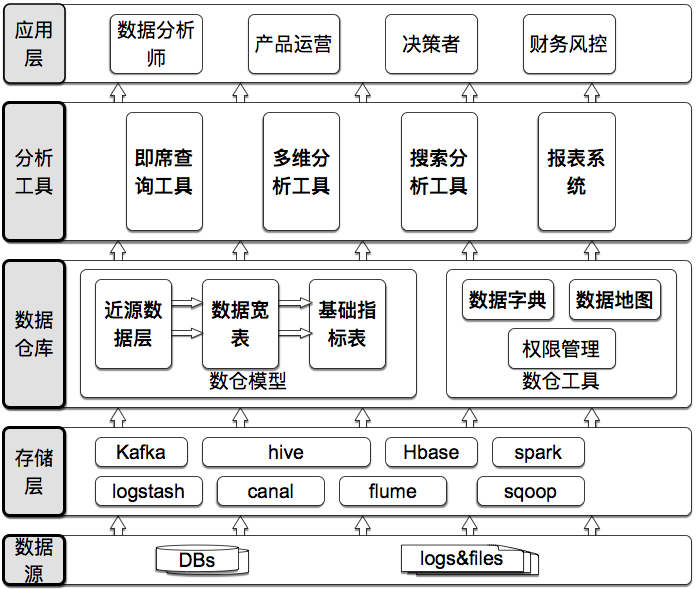
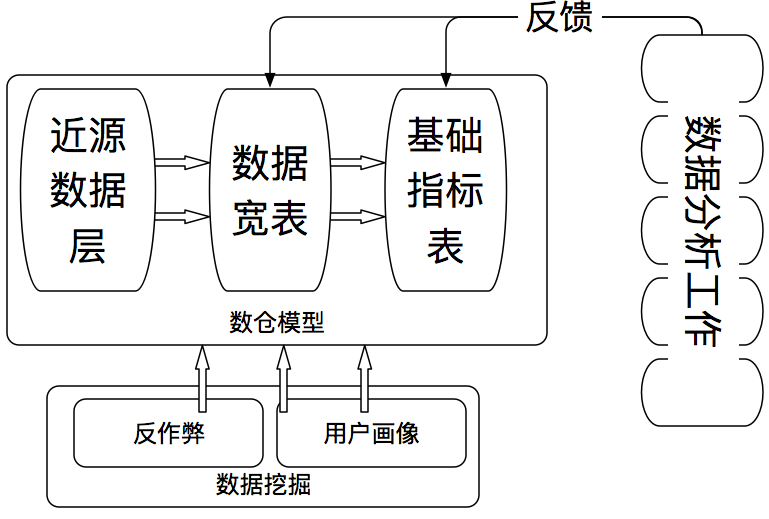
整体架构与面向人群:
数仓内部分层设计:
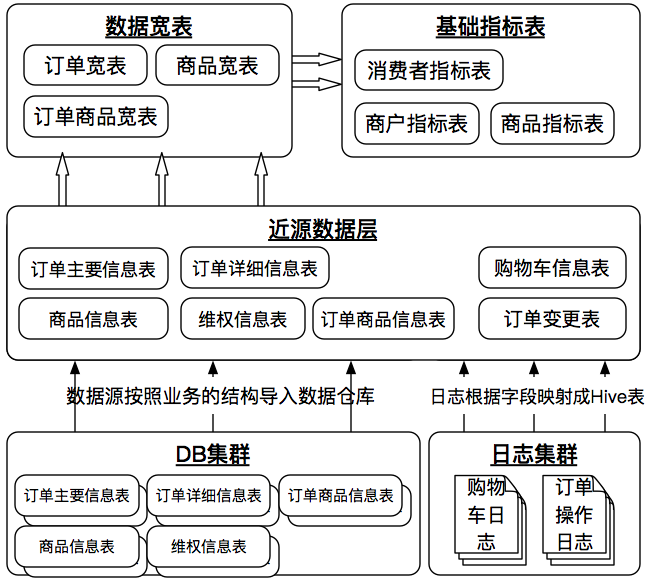
近源数据层:导入业务层的数据
- 将物理分片的分布式 DB 映射成一个 Hive 表
- 根据表的内容选择合适的 Hive 分区键
- 对于缓慢变化维进行处理, 让数据表可以反映变化
- 对于日志进行基本的处理映射成 Hive 表
中间层:合并业务数据
- 合并不同业务为统一过程:
- 业务数据有很多独立的市场或者版本, 他们客户和用户不同, 但是工作过程是一样的. 再比如 app 和 pc 的日志独立记录, 但是可以在一定程度上合并。
- 屏蔽脏数据, 比如典型的测试数据.
- 冗余字段. 把常用的 join 操作在中间层封装.
宽表用途:
1. 统一数据口径
计算宽表的时候会根据业务需求生成很多冗余字段, 比如对于疑似刷单交易, 很多业务如果都实现一遍的话, 势必会导致口径问题, 在设计订单宽表的时候我们根据风控模型加入一个字段是否为空壳交易. 这样在统计时候各方的口径都会一致. 同样脏数据问题也是通过这种方式解决.
2. 多表 join 问题
订单宽表一定程度上聚合常用的字段, 满足 80% 的数据分析需求. 加上合理的分区设计, 基本上查询是非常快速的.
3. 没有为所有近源数据表都封装中间层
购物车信息我们就没有完全封装, 因为他们的分析不常用.
订单宽表的设计需要做一个折中. 一方面设计完备的数据仓库是不现实的, 另一方面订单宽表的前提是足够常用, 对于不常用的数据我们的数据平台是支持直接操作的. 这符合互联网设计产品的一般思路.
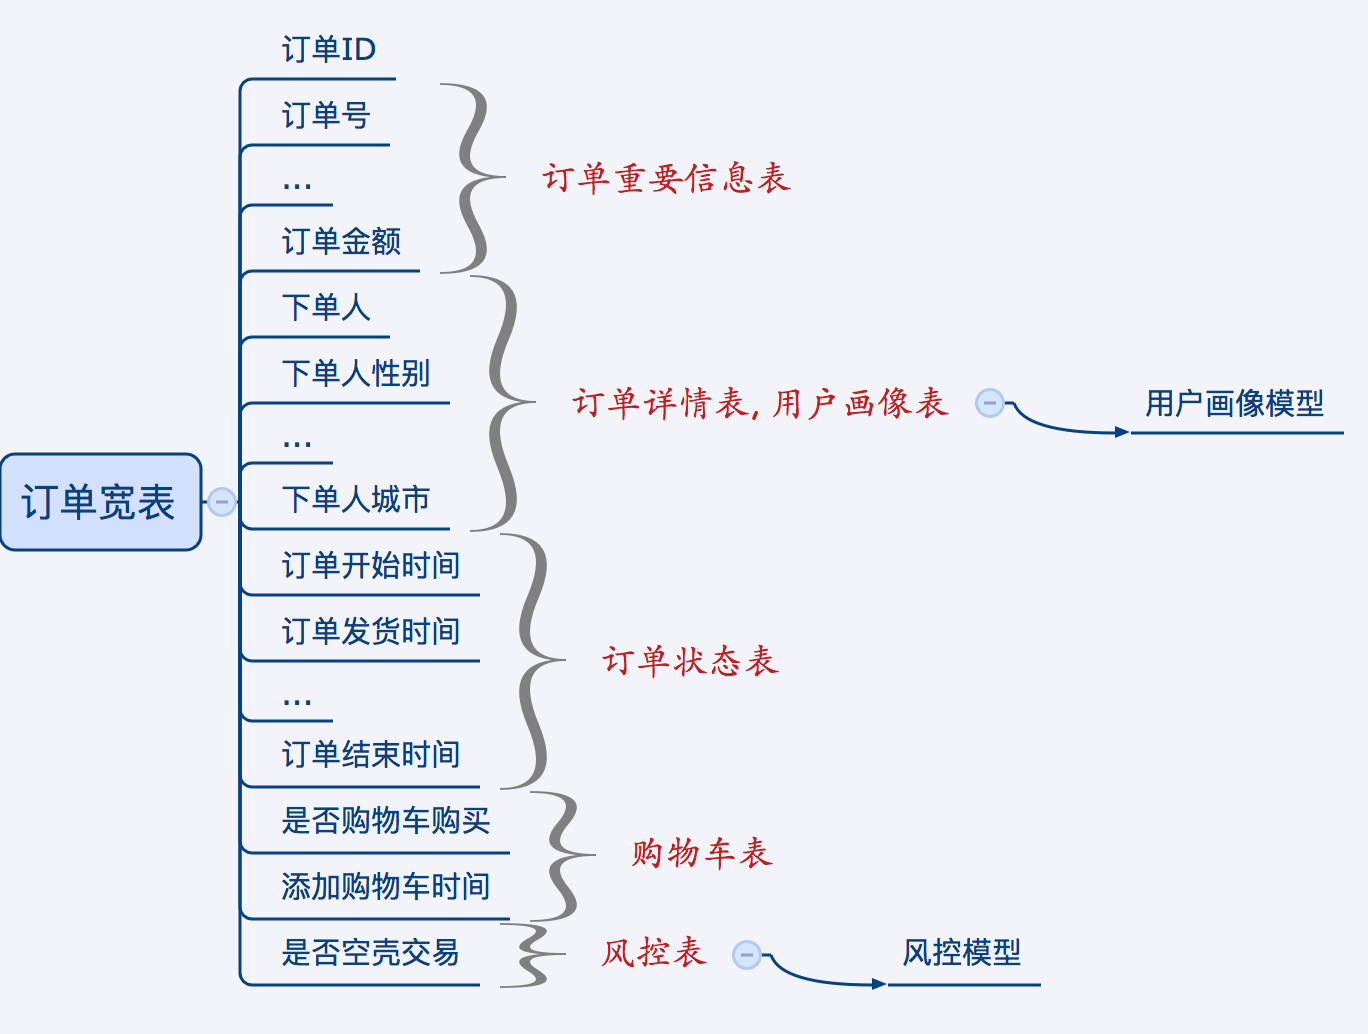
基础指标层:
在宽表的基础上提取出各种指标。
马蜂窝
马蜂窝数据中台起步建设:数仓的架构、模型与应用 的分层设计方案:
-
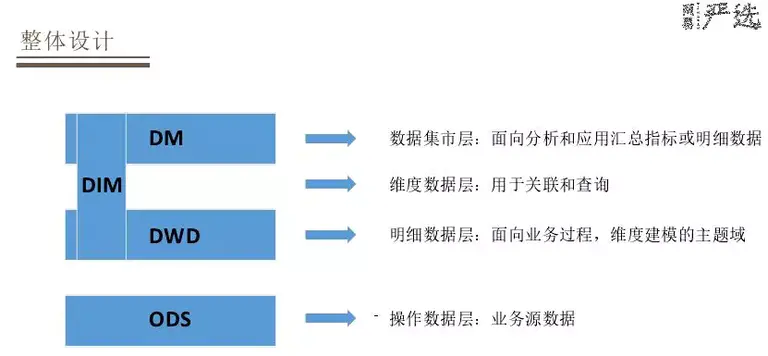
业务数据层:STG(数据缓冲区)、ODS(操作数据层)
STG:缓存来自 DB 抽取、消息、日志解析落地的临时数据,结构与业务系统保持一致;负责对垃圾数据、不规范数据进行清洗转换;只为 ODS 层服务。
ODS:业务明细数据保留区,负责保留数据接入时点后历史变更数据,数据原则上全量保留
-
公共数据层:DWD(明细数据层)、DWS(汇总数据层)、DIM(公共维度层)
DWD:整合后的业务过程明细数据 DWS:按主题对共性维度指标数据进行轻度、高度聚合 DIM:对维度进行标准化定义,维度信息共享
-
应用数据层:
DWA:面向各产品线、业务线的数据加工。
网易严选
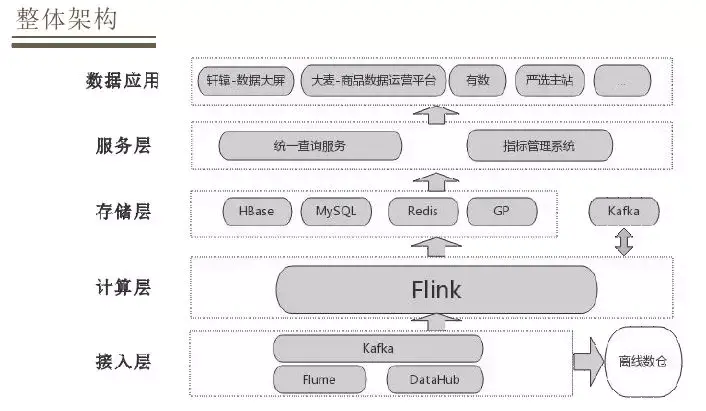
层次设计:
性能优化
网易严选
辅助工具
数据同步工具
*
任务调度平台
- Airflow
数据分析工具
有赞的分析工具层次:
- 即席查询系统:直接操作数据仓库,面向分析师
- 多维分析系统:面向一般运营人员,提供各种维度下的图表,(基于 kylin 引擎)
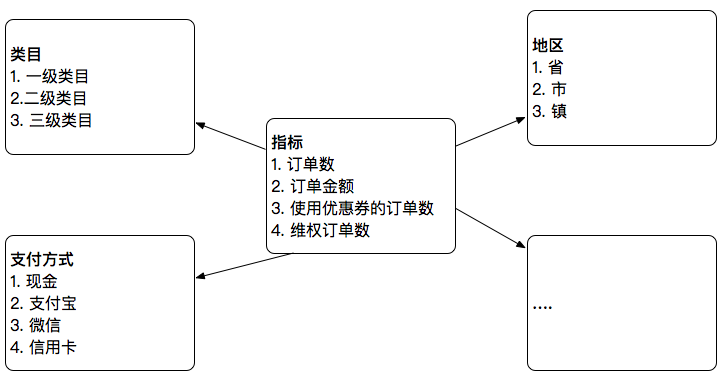
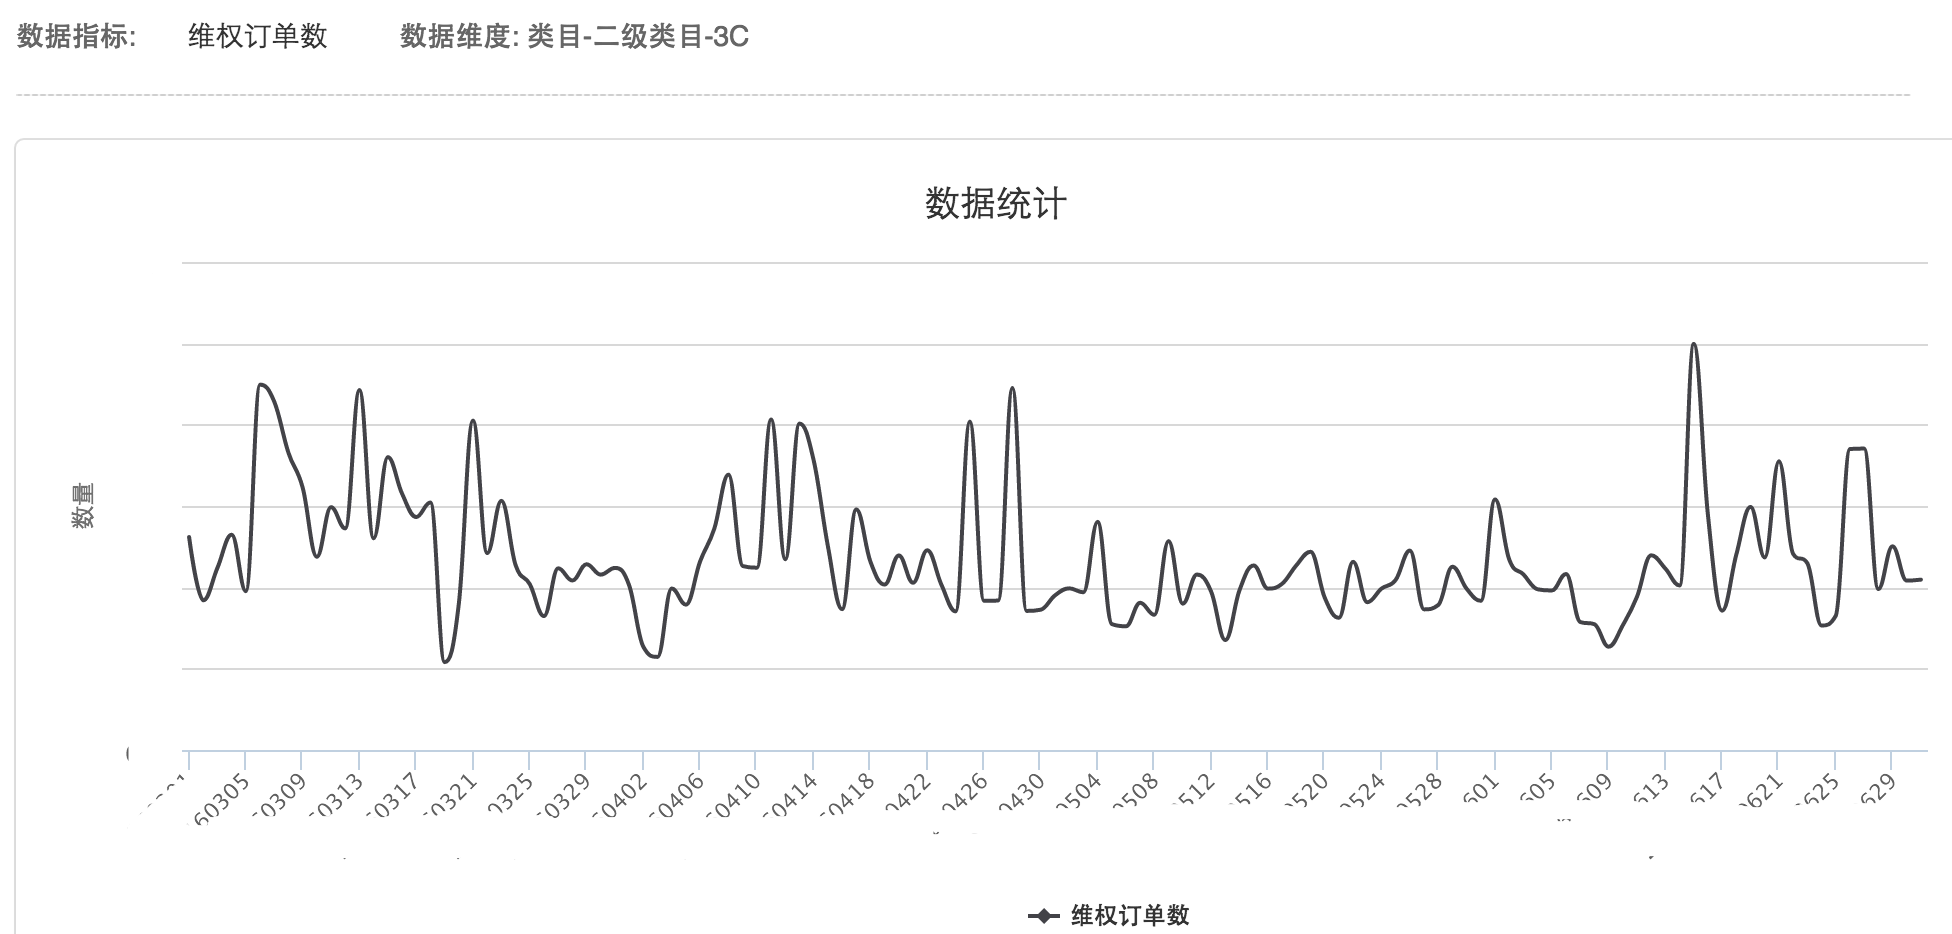
3C类目下的维权订单数的历史趋势:
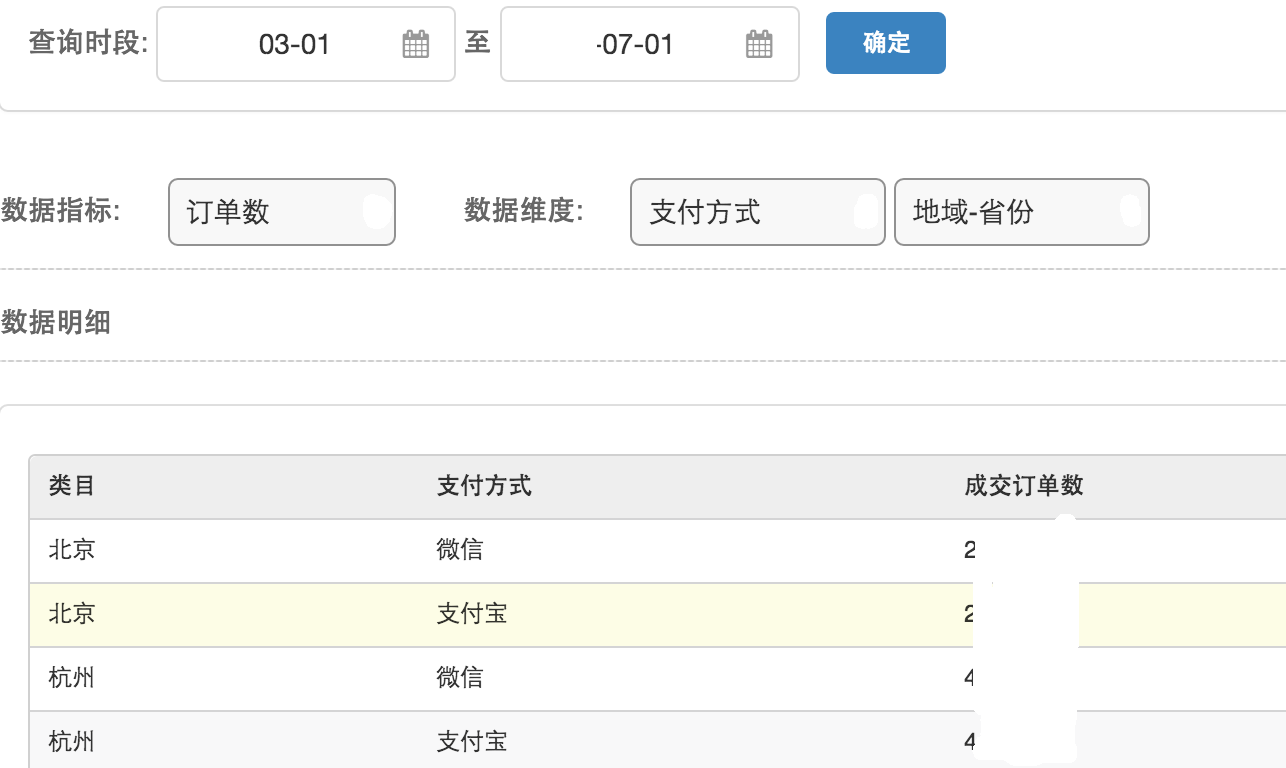
3~7月份,不同地区、不同支付方式 的订单数:
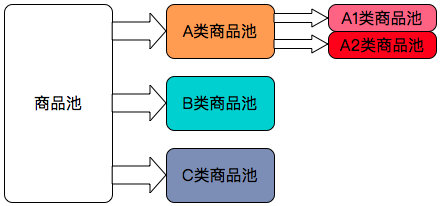
- 搜索分析系统:基于对于纬度建立索引的查询系统
根据销量和维权数维度筛选出A(优质)/B(精品)/C(劣质)类商品,在 A 类中继续根据其它属性筛选。
- 固定报表系统:特定数据需求
GMV报表、店铺报表、每周订单数等
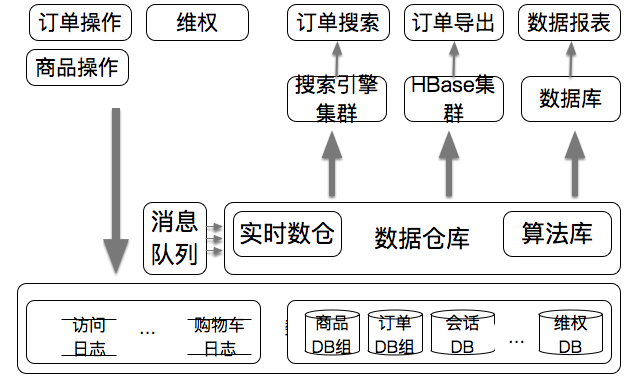
数据仓库充当业务数据层,以数据仓库为中心的架构:
权限设计
有赞:
- 权限分为库级、表级、字段级
- 库级权限:数据集市层采用,主题域人员对库有完整读写权限,个别情况设置表级和字段级别权限
- 表级权限:在落地层和数仓层,基于主题域开放
- 字段级权限:只针对敏感字段
元数据管理
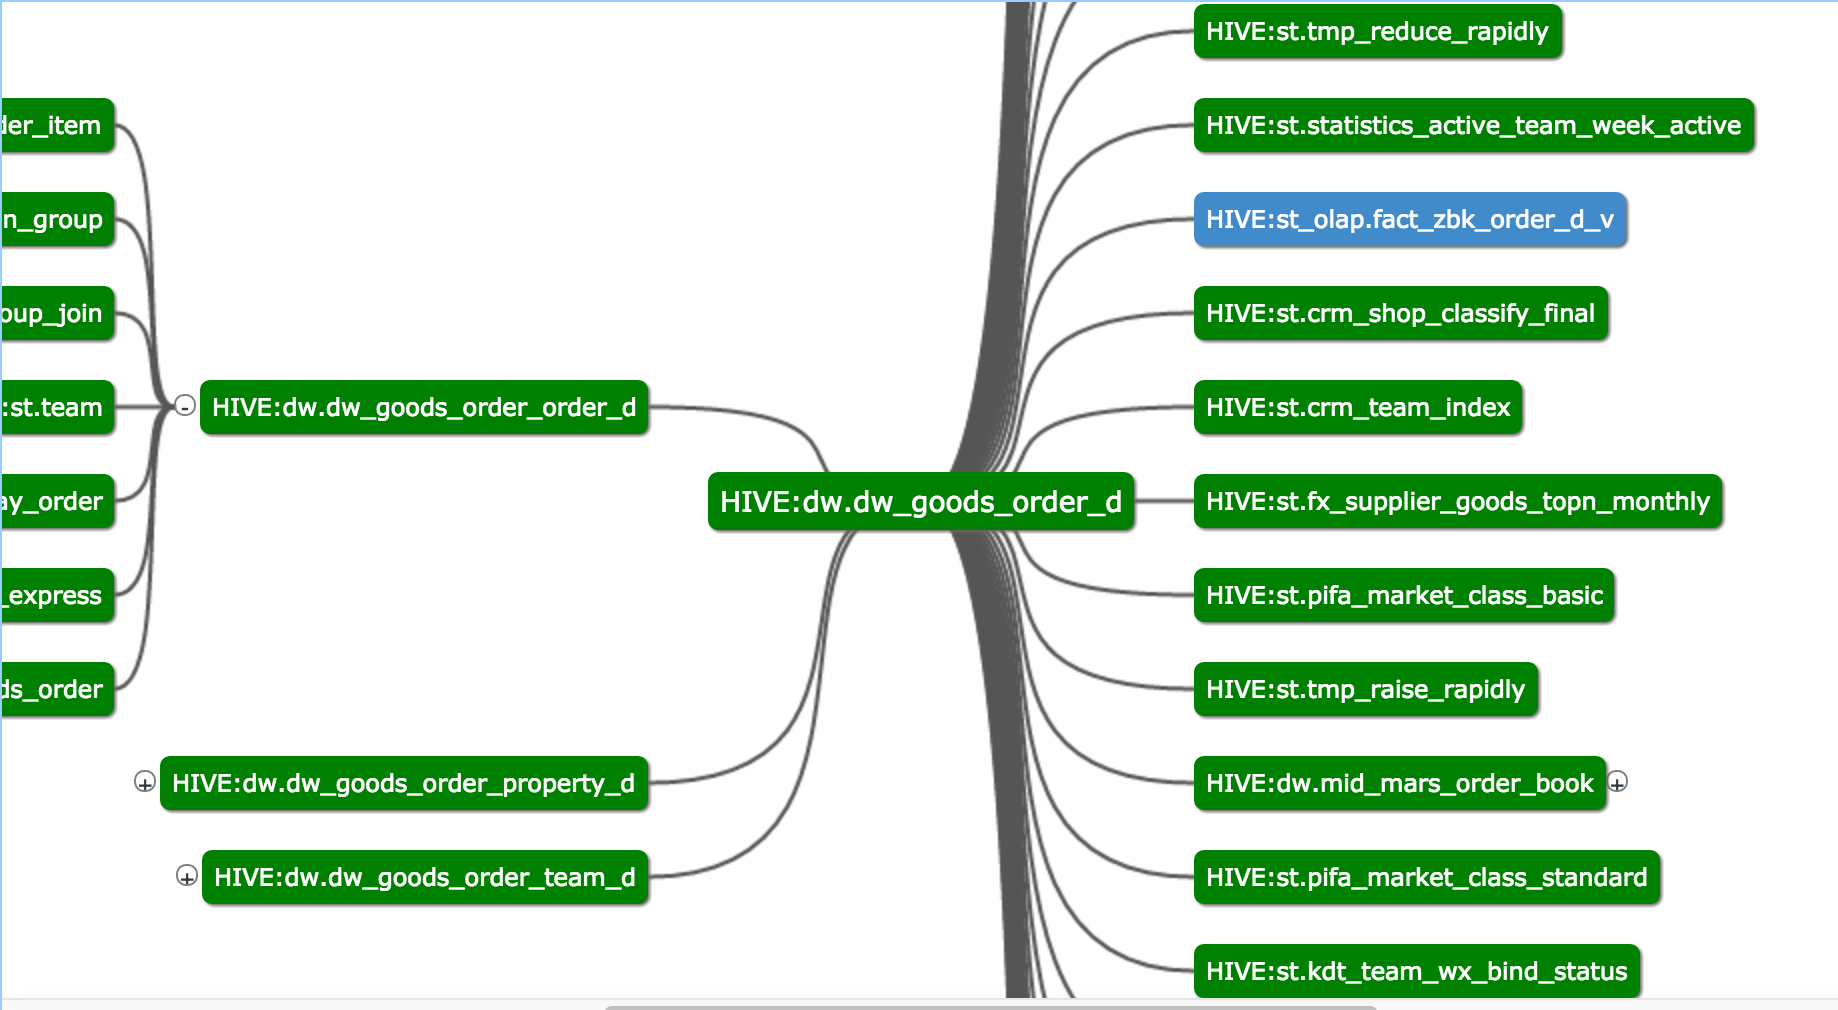
血缘:
有赞的数据地图:
数据知识:
有赞的数据字典
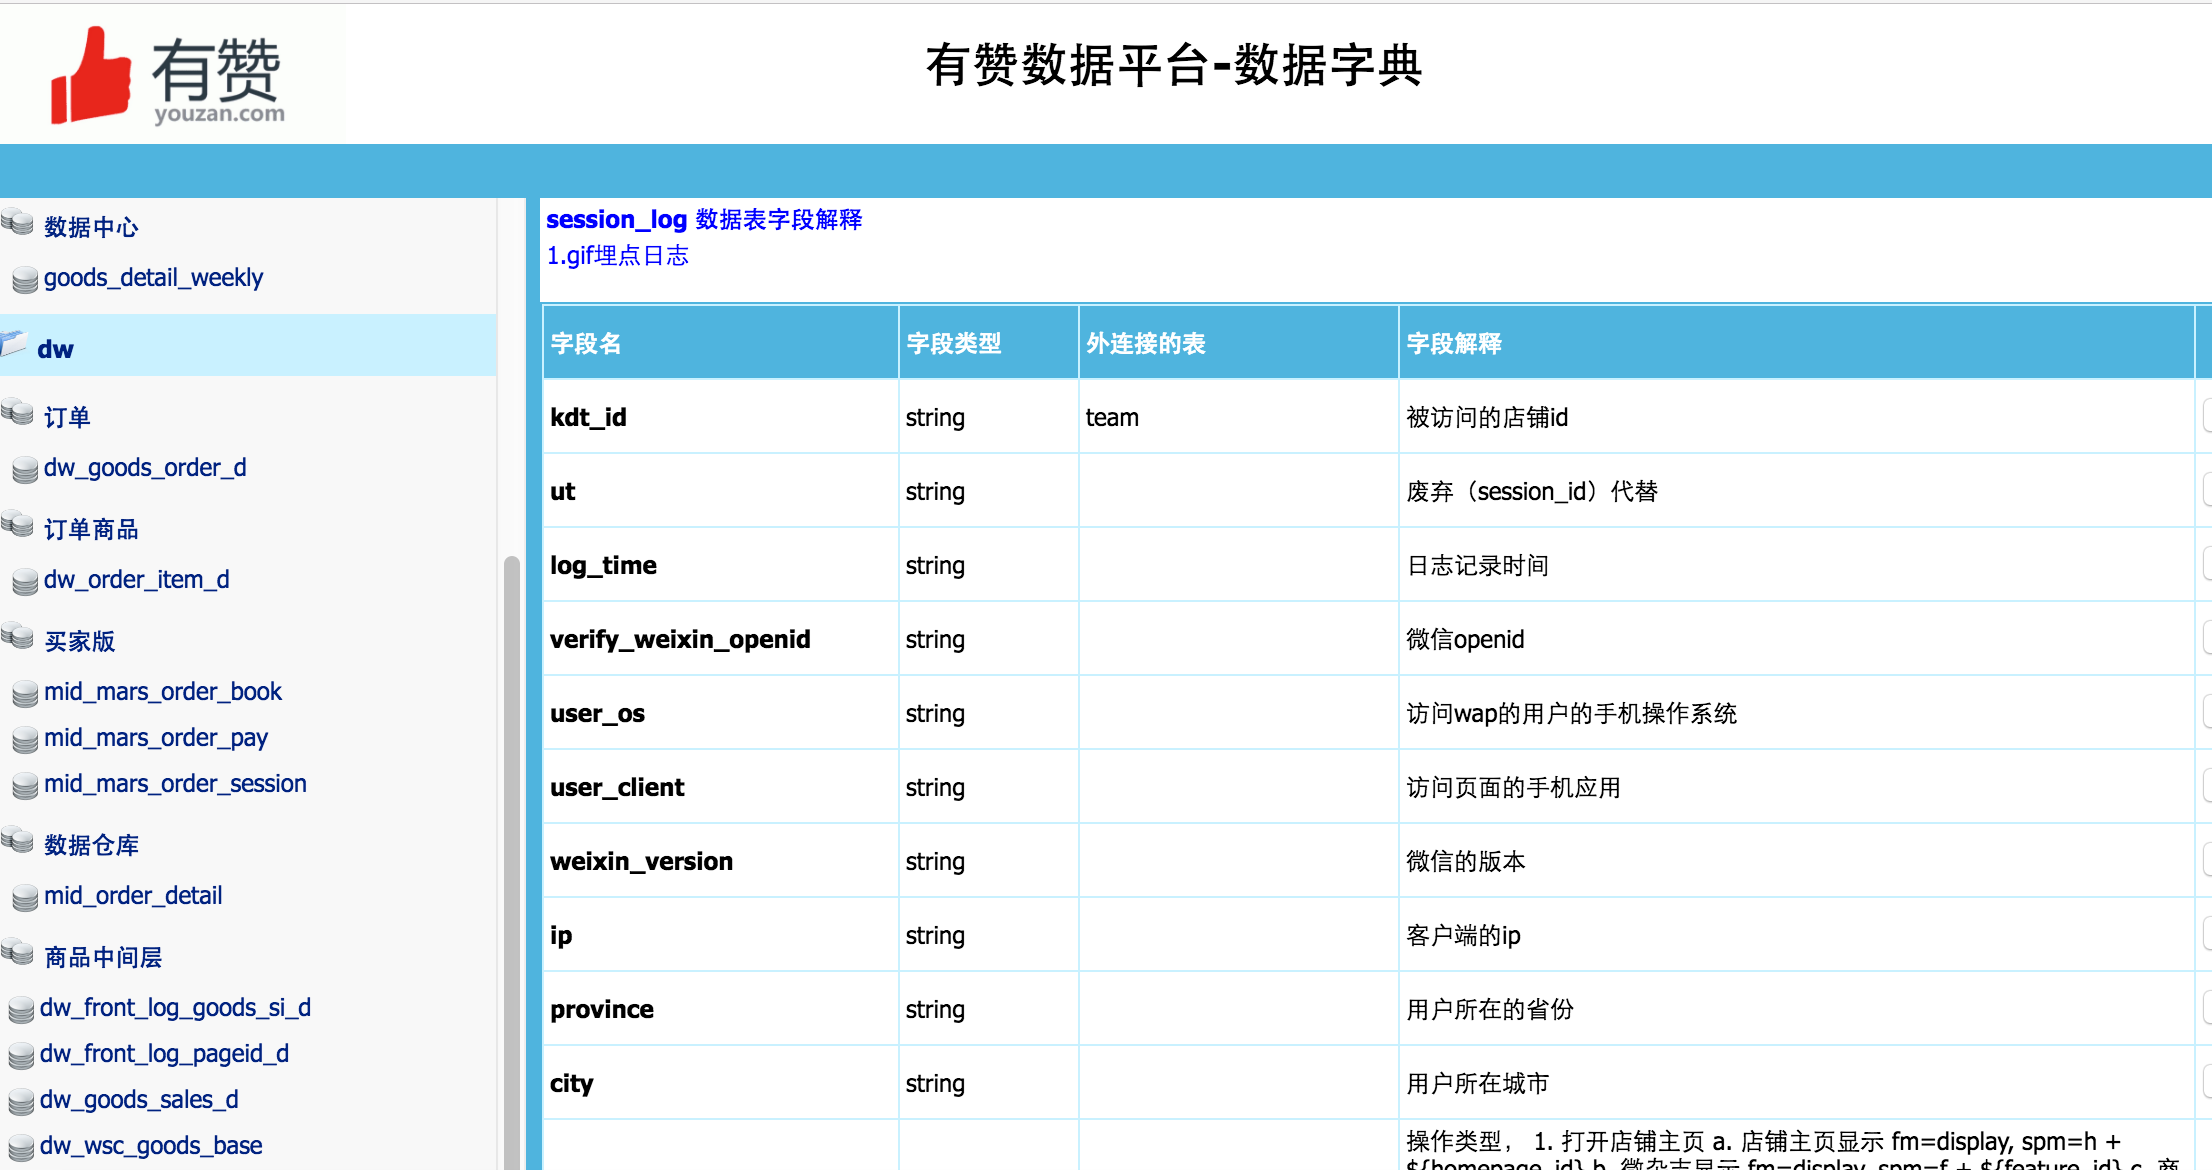
- 所有业务表字段都要求写注释
- 所有新建表都默认有基于系统时间的 created_at 和 updated_at
- 数据字典也逐步经由元数据系统演变成数据资产管理平台
应用
- 指标平台